Kik vagyunk?

A New Generation of Design Kft. egy feltörekvő vállalkozás, ami informatikával kapcsolatos szolgáltatásokat nyújt főképp nagyvállalatok számára.

Projekt Szolgáltatások

Cégünk sokéves tapasztalattal bír minőségbiztosítási, architektúra- és folyamat tervezési és információ biztonsági területeken. Folyamatosan követjük a nemzetközi szabványokat és irányvonalakat. Egyaránt ismerjük a multinacionális nagyvállalatok felépítését és működését, a telekommunikációs-, állami-, pénzügyi szektor megrendelőinek igényeit.

Krízismenedzsment

Sokrétű ismereteinknek köszönhetően képesek vagyunk a különféle informatikai projektek válságainak kezelésére. Hatékony projektcsapatunk képes bekapcsolódni a problémás projektekbe, átvenni annak irányítását a krízis alatt, majd azt rendezve visszaterelni a projektet olyan kerékvágásba, mely már a megfelelő úton halad a cél teljesítése érdekében.

Munkaerő kiajánlás

Kiterjedt kapcsolataink révén sikeresen tudunk munkaerőt ajánlani az IT szektor teljes területén. Olyan hiányszakmák esetében is tudunk megoldásokat biztosítani, mint tesztelő, tesztautomatizáló mérnök, alkalmazás üzemeltető és fejlesztő. Mivel főképp juniorokkal foglalkozunk, ezért programunk részét képezi az aktív mentorálás is.

Projekt szolgáltatások

Mi nem a varázslásban hiszünk, hanem a szakmai megoldásokban!

Legújabb cikkek

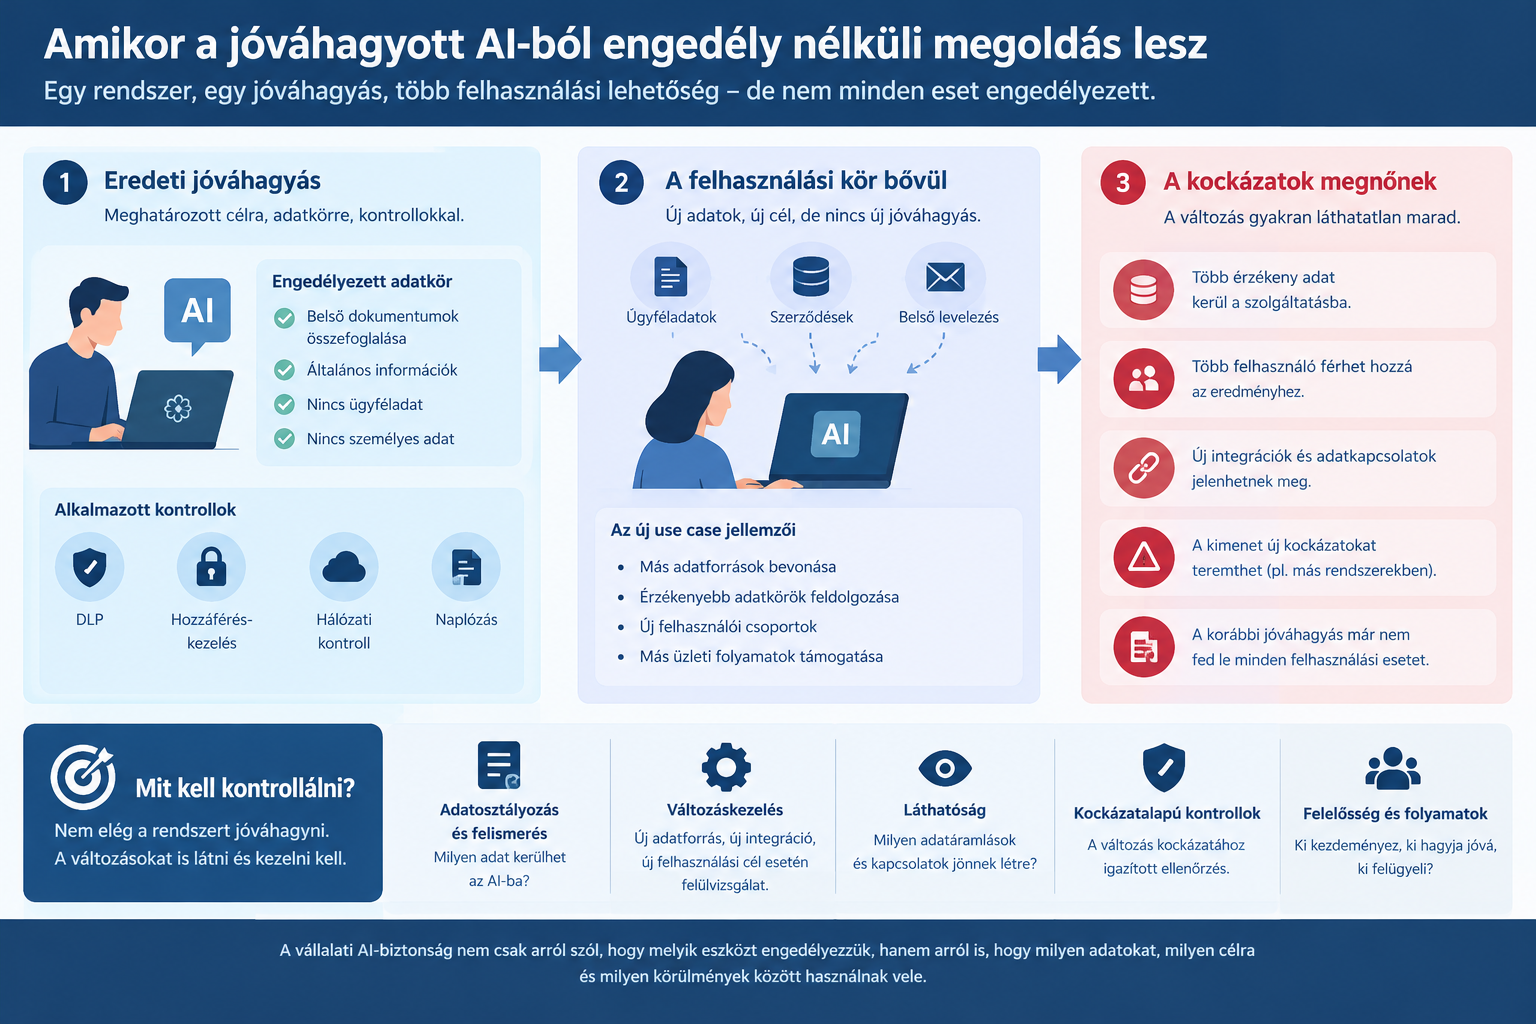
Amikor a jóváhagyott AI-rendszerből engedély nélküli megoldás lesz

Egy új use case nem feltétlenül része az eredeti jóváhagyásnak

Egy vállalat biztonsági és adatvédelmi szempontból megvizsgál egy AI-alapú megoldást. Meghatározzák, hogy mire használható, milyen adatokat dolgozhat fel, kik férhetnek hozzá, és milyen technikai, illetve szervezeti kontrollok szükségesek a működéséhez. A vizsgálat lezárul, a rendszer megkapja a szükséges jóváhagyásokat, és megkezdődik a használata.

Néhány hónappal később az üzleti terület (vagy egy társszervezet) felismeri, hogy ugyanez a rendszer egy további feladatra is alkalmas lehet. A szükséges módosítás viszonylag egyszerű: új adatforrást kapcsolnak hozzá, megváltoztatják a feldolgozási logikát, vagy egy új munkafolyamatba építik be.

Az új megoldás technikailag működik. Az eredeti rendszer már engedélyezett, a felhasználók hozzáférnek, a szükséges infrastruktúra rendelkezésre áll. Ezért az új felhasználási esetet nem kezelik új rendszerként, és nem indítanak új biztonsági felülvizsgálatot sem.

Csakhogy az új megoldás már nem feltétlenül az a rendszer, amelyet a vállalat korábban jóváhagyott.

Az eredeti alkalmazás például belső, általános dokumentumok összefoglalására kapott engedélyt. Az új változat már ügyféladatokat elemez, szerződéseket értékel vagy munkavállalói információkat dolgoz fel. Maga az AI-szolgáltatás nem változott, de a felhasználás célja, az adatköre és a kockázati profilja igen.

A probléma nem feltétlenül egy új, ismeretlen AI-eszköz megjelenése. Hanem az, hogy egy ismert és jóváhagyott rendszer képességeit a jóváhagyás keretein túl kezdik használni.

A jóváhagyás nem általános felhatalmazás

A vállalati rendszerek biztonsági jóváhagyása nem pusztán egy terméknévhez vagy technológiához kapcsolódik. A döntés meghatározott felhasználási környezetre vonatkozik.

A vizsgálat során a vállalat többek között azt mérlegelheti, hogy:

  • milyen üzleti célból használják a rendszert;
  • milyen adatokat dolgoz fel;
  • honnan származnak ezek az adatok;
  • mely felhasználók és szolgáltatások férnek hozzájuk;
  • milyen külső rendszerekkel kommunikál;
  • milyen adatmegőrzési, naplózási és hozzáférés-kezelési feltételek érvényesülnek;
  • milyen következményekkel járhat egy hiba vagy jogosulatlan adatközlés.

Ezek a körülmények együtt határozzák meg a rendszer kockázatát.

Ha egy jóváhagyott alkalmazáshoz új adatforrást kapcsolnak, az eredeti kockázatértékelés már nem feltétlenül írja le megfelelően az új működést. Ugyanez igaz akkor is, ha a rendszer korábbi funkcióját egy másik üzleti folyamatban kezdik alkalmazni, vagy új felhasználói csoport számára teszik elérhetővé.

A rendszer neve és technológiai alapja változatlan maradhat. A biztonsági szempontból releváns körülmények azonban megváltozhatnak.

Ezért az eredeti jóváhagyást nem lehet automatikusan kiterjeszteni minden olyan felhasználási esetre, amely ugyanarra a technológiára épül.

A változás gyakran nem rendszerbevezetésként jelenik meg

A hagyományos vállalati működésben egy új alkalmazás beszerzése vagy bevezetése rendszerint jól felismerhető esemény. Projekt indul, követelmények készülnek, a biztonsági terület véleményezi a megoldást, majd megtörténik a bevezetés.

Egy már működő AI-rendszer új célra történő felhasználása egészen másképp nézhet ki.

Lehet, hogy egy fejlesztő egyszerűen hozzáad egy új adatforrást. Egy üzleti elemző új feladatot állít be. Egy automatizációs szakember egy meglévő AI-funkciót egy másik folyamatba illeszt. Egy belső alkalmazás új táblázatokhoz vagy adatbázisokhoz kap hozzáférést.

Ezek a módosítások technikailag kisebb jelentőségűnek tűnhetnek, miközben biztonsági szempontból lényeges változást jelentenek.

A vállalat így úgy vezethet be új adatfeldolgozási folyamatot, hogy közben nem érzékeli: valójában új felhasználási eset jött létre.

Ez a jelenség különösen veszélyes akkor, ha az eredeti rendszer már megbízhatónak számít a szervezetben. A korábbi jóváhagyás biztonságérzetet teremt, és a későbbi módosításokat is automatikusan elfogadhatónak tekinthetik.

Mitől válhat kockázatossá az új use case?

Tegyük fel, hogy egy vállalat egy AI-alapú dokumentumfeldolgozó rendszert kizárólag belső, nem bizalmas anyagok összefoglalására engedélyezett.

Később a pénzügyi terület ugyanazt a megoldást kezdi használni számlák és szerződések feldolgozására. A HR-osztály munkavállalói dokumentumokat szeretne elemezni vele, az ügyfélszolgálat pedig ügyféllevelezéseket kapcsol hozzá.

Ezek a felhasználási esetek nem pusztán új feladatokat jelentenek. Más adatvédelmi, üzleti titokkal kapcsolatos és hozzáférés-kezelési követelményeket is felvethetnek.

Az új adatforrás például olyan információkat tartalmazhat, amelyekhez az eredeti alkalmazás felhasználói nem férhetnének hozzá közvetlenül. Az AI-rendszer integrációja révén azonban ezek az információk összefoglalva vagy más formában elérhetővé válhatnak számukra.

Az is előfordulhat, hogy az új adatokat olyan szolgáltatás dolgozza fel, amelynek adatmegőrzési vagy feldolgozási feltételeit erre az adatkörre nem értékelték.

Egy másik esetben az AI kimenete már nem egyszerű tájékoztatásra szolgál, hanem döntést támogat egy üzleti folyamatban. Ezzel a tévedések lehetséges következményei is megváltozhatnak.

A lényeg, hogy az új use case kockázata nem feltétlenül az AI-modellből ered. Sokszor az új adatforrás, az új hozzáférés, az eltérő üzleti cél vagy a megváltozott felhasználási környezet hozza létre.

A rendszer engedélyezett, de a felhasználás már nem az

Ez a helyzet az ellenőrzés szempontjából is különleges.

Ha a vállalat csak azt vizsgálja, hogy az alkalmazott AI-szolgáltatás szerepel-e az engedélyezett rendszerek listáján, akkor az új felhasználási eset láthatatlan maradhat. A technológia megfelel a nyilvántartásnak, a hozzáférés működik, a rendszer pedig a korábbi jóváhagyás alapján megbízhatónak tűnik.

A tényleges működés azonban már eltérhet attól, amit a vállalat felülvizsgált.

Ezért két külön kérdést kell kezelni:

  1. Engedélyezett-e maga a rendszer?
  2. Engedélyezett-e a rendszer konkrét használata az adott célra, adatkörrel és integrációkkal?

A két kérdés nem helyettesíti egymást. Az elsőre adott igen nem jelenti automatikusan azt, hogy a másodikra is igen a válasz.

Ez a különbség nem kizárólag az AI-ra igaz. A vállalati rendszerek és adatintegrációk világában régóta ismert probléma, de az AI-eszközök gyors konfigurálhatósága, egyszerű integrálhatósága és sokoldalúsága különösen könnyen előidézheti.

Mit kellene kontrollálni?

A megoldás nem az, hogy minden apró konfigurációs változtatásból új, teljes körű rendszerbevezetési projektet kell létrehozni. Ez aránytalanul lassúvá tenné az üzleti működést, és arra ösztönözhetné a felhasználókat, hogy a hivatalos folyamatokon kívül keressenek megoldást.

Ehelyett olyan változáskezelésre van szükség, amely felismeri, ha egy módosítás érdemben megváltoztatja a rendszer kockázatát.

Ennek része lehet:

  • A jóváhagyás hatókörének pontos rögzítése. Nem elegendő az alkalmazás nevét és tulajdonosát nyilvántartani. A jóváhagyásnak tartalmaznia kell az engedélyezett célokat, adatköröket, integrációkat és lényeges használati feltételeket is.
  • A lényeges változások kötelező felülvizsgálata. Új adatkör, új adatforrás, új felhasználói csoport, új integráció vagy megváltozott döntési szerep esetén meg kell vizsgálni, hogy szükséges-e új jóváhagyás.
  • A technikai változások láthatóvá tétele. Az adatkapcsolatok, jogosultságok, API-integrációk és konfigurációk változásainak naplózása segíthet felismerni, ha a rendszer túllépi az eredetileg meghatározott kereteket.
  • A kockázathoz igazított ellenőrzés. Egy alacsony kockázatú változtatás egyszerűsített eljárással is jóváhagyható. Érzékeny adatok bevonása vagy új, kritikus üzleti funkció esetén viszont részletesebb vizsgálat indokolt.
  • Egyértelmű felelősség. A rendszer üzleti tulajdonosának tudnia kell, milyen célra és milyen adatokkal használható a megoldás. Az új felhasználási eset kezdeményezőjének pedig jeleznie kell, ha a tervezett változtatás túlmutat az eredeti engedélyezésen.

A cél nem a változások megakadályozása, hanem az, hogy a lényeges változások ne maradjanak ellenőrizetlenek.

A valódi probléma az engedélyezés és a tényleges működés közötti rés

Egy vállalat rendelkezhet jól működő AI-szabályzattal, engedélyezett szolgáltatások listájával és részletes biztonsági felülvizsgálati eljárással, miközben a jóváhagyott rendszerek felhasználása fokozatosan túlnő az eredeti kereteken.

Ilyenkor nem feltétlenül a szabályozás hiányzik. Lehet, hogy a szervezet nem kezeli megfelelően a már jóváhagyott rendszerek életciklusa során bekövetkező változásokat.

A biztonsági felülvizsgálat ugyanis nem feltétlenül örök érvényű igazolás. Egy adott állapotra, meghatározott feltételek mellett születik. Ha ezek a feltételek lényegesen megváltoznak, a korábbi döntés érvényességét is újra kell értékelni.

Ez különösen fontos az AI esetében, ahol egy meglévő megoldás újrafelhasználása gyakran gyorsabb és egyszerűbb, mint egy teljesen új rendszer bevezetése. A technikai újrafelhasználás azonban nem jelent automatikus biztonsági jóváhagyást.

Összegzés

Az egyik legkönnyebben figyelmen kívül hagyható AI-biztonsági kockázat nem egy ismeretlen szolgáltatás megjelenése, hanem egy már engedélyezett rendszer észrevétlen továbbfejlesztése vagy új célra történő felhasználása.

A rendszer eredeti jóváhagyása meghatározott célra, adatkörre és működési feltételekre vonatkozott. Ha ezeket a kereteket valaki engedély nélkül kiterjeszti, a vállalat olyan adatfeldolgozást végezhet, amelyet valójában soha nem vizsgáltak meg.

Nem elég a rendszert jóváhagyni. Azt is kontrollálni kell, hogy a jóváhagyott rendszerből milyen új megoldásokat, adatkapcsolatokat és felhasználási eseteket hoznak létre.

Shadow AI és DLP – mit látunk valójában?

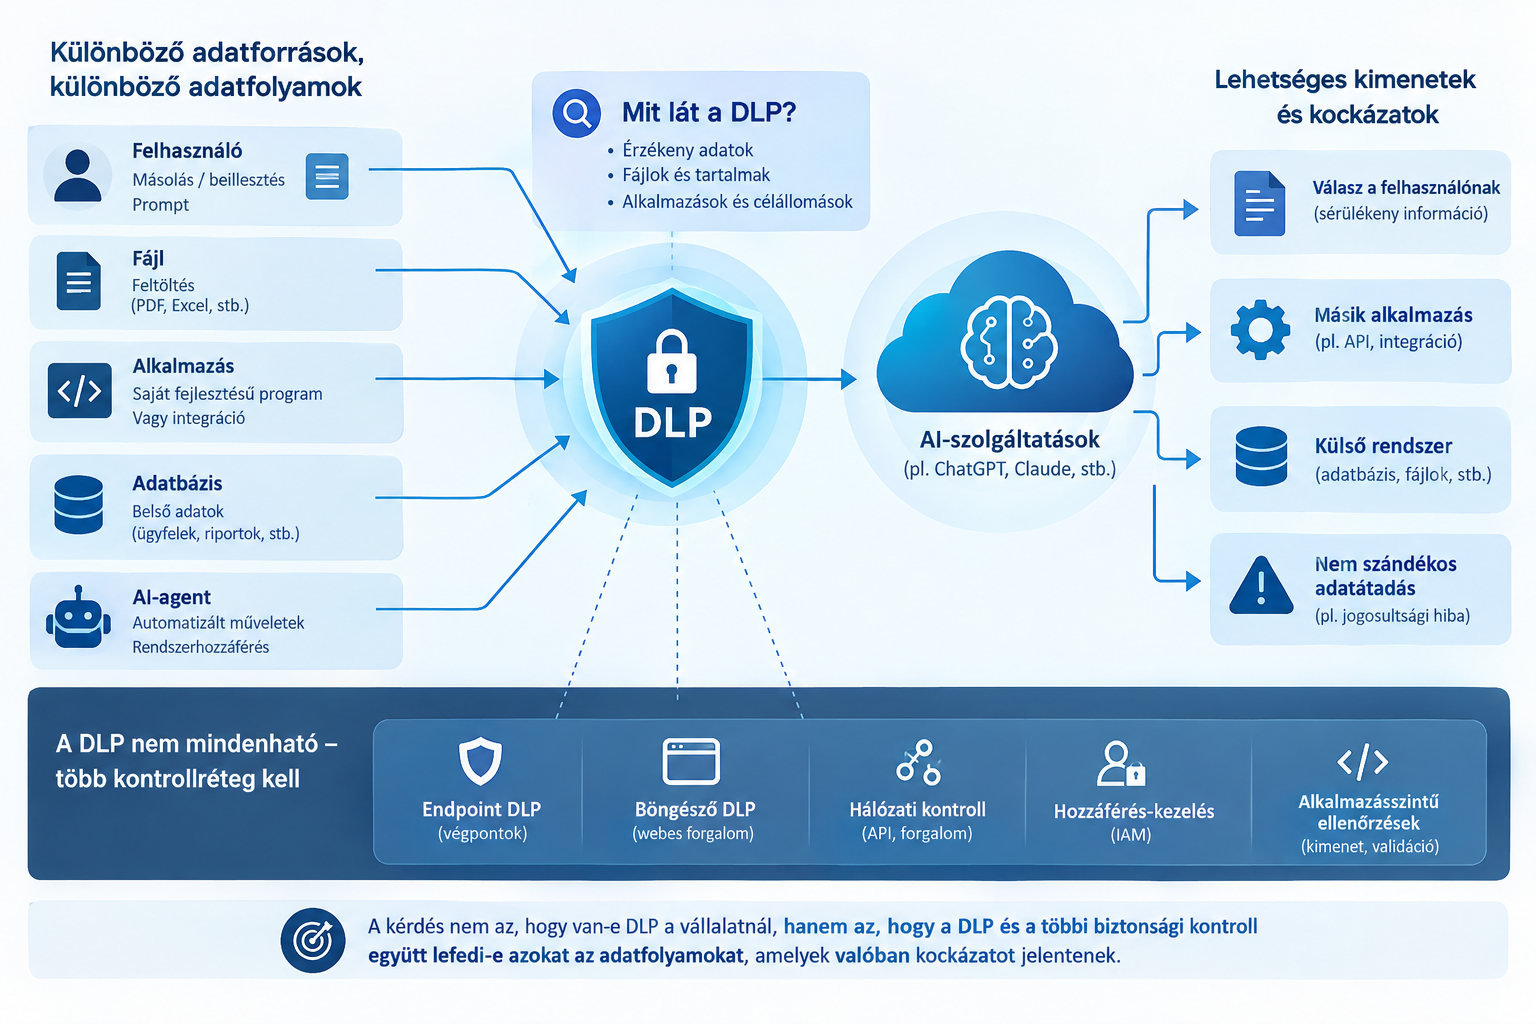
Az AI-szolgáltatások használatával új adatáramlások jelennek meg a vállalati környezetben. A kérdés az, hogy ezekből mit képes felismerni, ellenőrizni és megakadályozni egy DLP-rendszer.

A Shadow AI egyik legfontosabb információbiztonsági kérdése, hogy a vállalat képes-e érzékelni, milyen adatokat továbbítanak a munkatársak a különböző AI-szolgáltatások felé.

Ez elsőre egyszerű DLP-feladatnak tűnhet. A gyakorlatban azonban az AI használata többféle adatmozgást jelent, amelyek eltérő módon figyelhetők meg és kontrollálhatók.

Más biztonsági kihívást jelent, ha egy munkatárs bizalmas dokumentumot tölt fel egy nyilvános chatbotba, és mást, ha egy saját fejlesztésű alkalmazás automatikusan továbbít adatokat egy külső AI API-nak.

A két esetben közös, hogy érzékeny vállalati információ kerülhet olyan környezetbe, amely felett a szervezetnek korlátozott rálátása vagy kontrollja van.

Ezért nem elegendő azt vizsgálni, hogy rendelkezik-e a vállalat DLP-megoldással. Azt is meg kell érteni, hogy hol helyezkedik el a kontroll, milyen adatokat képes vizsgálni, és mely adatáramlások maradnak kívül a látóterén.

1. A legegyszerűbb eset: amikor a felhasználó adatot másol be

A legismertebb Shadow AI-helyzet, amikor egy munkatárs megnyit egy nyilvános AI-szolgáltatást, és bemásol egy vállalati dokumentumból származó szöveget.

Például egy szerződés elemzését kéri, összefoglaltat egy incidensjelentést, vagy segítséget kér egy forráskód hibájának javításához.

A felhasználó számára ez egy egyszerű munkafolyamat. Biztonsági szempontból azonban adatátadás történik egy külső szolgáltatás felé.

Ha a DLP megfelelő ponton képes ellenőrizni a műveletet, felismerheti, hogy az elküldeni kívánt tartalom érzékeny információt tartalmaz-e. A megoldás konfigurációjától és támogatott funkcióitól függően akár meg is akadályozhatja az adatátadást.

A Microsoft Purview dokumentációja például külön foglalkozik a harmadik fél generatív AI-szolgáltatásaiba történő szövegbeillesztés és fájlfeltöltés szabályozásával.

Fontos különbség van azonban aközött, hogy a vállalat látja egy AI-szolgáltatás használatát, és aközött, hogy képes megvizsgálni az oda küldött tartalmat.

Az alkalmazás felismerése önmagában nem jelenti az adatvesztés kontrollálását.

2. A fájlfeltöltés külön kontrollt igényelhet

Nem minden esetben másolja be a felhasználó a dokumentum tartalmát. Gyakran egyszerűbb feltölteni egy teljes PDF-et, Excel-táblázatot vagy forráskódfájlt.

Ilyenkor a DLP-nek a fájl tartalmát, típusát és az adatátadás körülményeit is figyelembe kell vennie.

A vizsgálat eredményességét befolyásolhatja például a fájl formátuma, mérete, titkosítása, valamint az, hogy az adatátadás milyen böngészőn vagy alkalmazáson keresztül történik.

Egy megfelelően kialakított kontrollrendszernek ezért nem pusztán azt kell rögzítenie, hogy a munkatárs AI-t használt. Lehetőség szerint azt is meg kell állapítania, hogy történt-e fájlfeltöltés, és a feltöltött tartalom sért-e valamely adatvédelmi vagy információbiztonsági szabályt.

A különbség jelentős: egy AI-szolgáltatás használata önmagában nem feltétlenül kockázatos, egy bizalmas ügyféllista feltöltése viszont már konkrét biztonsági esemény lehet.

3. Miért nem elég az AI-szolgáltatások listázása?

A Shadow AI felderítésének egyik lehetséges kiindulópontja a vállalati környezetből elérhető AI-szolgáltatások azonosítása.

Ez segít feltérképezni, milyen szolgáltatásokat használnak a munkatársak, és melyek igényelnek további vizsgálatot. Önmagában azonban nem ad teljes képet az adatmozgásokról.

Egy alkalmazott például nem közvetlenül egy chatbot weboldalán dolgozik, hanem egy böngészőbővítményt használ. Egy fejlesztő saját programot készít, amely külső AI API-val kommunikál. Az is előfordulhat, hogy egy vállalati alkalmazás integrál valamilyen AI-szolgáltatást a háttérben.

Ezek a helyzetek eltérő hálózati és alkalmazásszintű adatáramlásokat eredményeznek.

A vállalatnak ezért nemcsak az AI-szolgáltatások használatát érdemes felderítenie, hanem azt is, hogy milyen alkalmazásokon keresztül, milyen adatokkal és milyen célállomások felé történik adatátadás.

4. Az API-használat a DLP egyik fontos vakfoltja lehet

A fejlesztők és az automatizációk esetében az adatátadás gyakran nem böngészőn keresztül történik.

Egy saját alkalmazás például vállalati adatbázisból olvas adatokat, feldolgozza azokat, majd egy külső AI API-nak küldi el elemzésre.

Ilyenkor a felhasználó nem feltétlenül végez másolást vagy fájlfeltöltést. Az adatküldést maga a program hajtja végre.

Ez különösen fontos az AI segítségével készített belső alkalmazások esetében. Egy munkatárs létrehozhat egy scriptet, amely automatikusan összefoglalja a vállalati riportokat, feldolgozza a hibajegyeket, vagy ügyféladatokat elemez.

Ha a fejlesztés során nem vizsgálják meg az adatkezelést, a program akár olyan információkat is továbbíthat külső szolgáltatásnak, amelyek kezelésére nem kapott engedélyt.

A böngészőalapú DLP ebben az esetben önmagában nem feltétlenül elegendő. A hálózati kontrollok, az API-használat felügyelete, a hozzáférés-kezelés és az alkalmazásszintű ellenőrzések egyaránt szerepet kaphatnak.

Az adatvesztés nem attól függ, hogy egy ember vagy egy program indítja-e el az adatátadást.

5. A legnehezebb kérdés: mit tekintünk érzékeny adatnak?

A DLP hatékonysága nagymértékben függ attól, hogy a szervezet milyen adatok védelmét határozza meg célként.

Viszonylag egyszerű lehet felismerni egy bankkártyaszámot, egy meghatározott formátumú személyes azonosítót vagy egy ismert titkos kulcsot. Nehezebb feladat egy belső üzleti terv, egy szerződéses tárgyalás részlete vagy egy vállalati incidens leírásának érzékenységét megítélni.

Az ilyen információk nem feltétlenül tartalmaznak felismerhető azonosítókat vagy előre meghatározott mintákat.

Egy dokumentum tartalma önmagában akár ártalmatlannak is tűnhet, miközben egy konkrét ügyféllel, projekttel vagy üzleti döntéssel összefüggésben már bizalmas információt jelent.

Ezért a DLP-szabályokat célszerű adatbesorolásra, tartalomelemzésre és a rendelkezésre álló üzleti kontextusra építeni. Egyetlen felismerési módszer nem feltétlenül képes minden érzékeny információt megbízhatóan azonosítani.

6. Nem csak a modellnek küldött adat jelent kockázatot

Az AI-adatbiztonságot gyakran kizárólag a felhasználói bemenet oldaláról vizsgáljuk. A kockázatok azonban az AI által előállított eredményekben is megjelenhetnek.

Egy vállalati AI-alkalmazás például belső dokumentumokból dolgozik, majd választ ad egy felhasználó kérdésére. Ha a rendszer jogosultságkezelése nem megfelelő, olyan adatokat is megjeleníthet, amelyekhez a felhasználónak nem lenne szabad hozzáférnie.

Ez már nem egyszerűen egy külső szolgáltatásba történő adatfeltöltés problémája. A biztonsági hiba az információ vállalaton belüli jogosulatlan hozzáférhetővé válása lehet.

Hasonló kérdés merül fel akkor, ha az AI által generált kimenetet egy másik alkalmazás automatikusan feldolgozza. Egy nem megfelelően ellenőrzött SQL-lekérdezés, parancs vagy más generált tartalom további biztonsági problémákat okozhat.

Az OWASP LLM-alkalmazásokra vonatkozó útmutatói ezért külön foglalkoznak az érzékeny információk felfedésével és a generált kimenetek nem megfelelő kezelésével.

Ezeket a kockázatokat nem lehet minden esetben hagyományos DLP-vel kezelni. Szükség lehet alkalmazásszintű jogosultságkezelésre, kimenetellenőrzésre és biztonságos fejlesztési gyakorlatokra is.

7. Milyen adatfolyamokat érdemes kontrollálni?

A vállalati AI-biztonság kialakításakor célszerű az egyes adatátadási helyzeteket külön megvizsgálni.

Adatátadási helyzetElsődleges kontrolllehetőség
Szöveg bemásolása egy AI-chatbeEndpoint- vagy böngészőalapú DLP
Dokumentum feltöltése AI-szolgáltatásbaFájltartalom-vizsgálat és DLP
Külső AI API használata saját programbólAPI-felügyelet, hálózati kontrollok
Belső adatbázis összekapcsolása AI-valJogosultságkezelés, adatminimalizálás, alkalmazásszintű kontroll
AI által generált válasz megjelenítéseHozzáférés-ellenőrzés és kimenetvalidáció
AI-agent műveletei vállalati rendszerekbenIAM, minimális jogosultság és műveletfelügyelet

A táblázatban szereplő kontrollok nem minden esetben helyettesítik egymást. A megfelelő megoldás attól függ, hol történik az adatátadás, milyen adatokról van szó, és milyen technikai lehetőségeket biztosít az adott környezet.

A cél nem az, hogy minden adatmozgást ugyanazzal az eszközzel próbáljunk kezelni, hanem az, hogy minden lényeges adatátadási ponton legyen megfelelő felderítés, megelőzés vagy ellenőrzés.

8. A DLP nem lát mindent

A DLP-rendszerek képességeit könnyű túlbecsülni. Egy vállalat attól, hogy rendelkezik DLP-vel, még nem feltétlenül lát minden AI-val kapcsolatos adatmozgást.

A láthatóság függ a telepített megoldástól, a konfigurációtól, a használt alkalmazásoktól, a böngésző támogatásától és attól is, hogy az adatátadás mely ponton halad át a kontrollon.

Egy kezelt végponton, támogatott böngészőben végrehajtott fájlfeltöltés jól meghatározott körülmények között vizsgálható és blokkolható lehet. Egy saját fejlesztésű program által kezdeményezett API-hívás azonban egészen más felügyeleti megközelítést igényelhet.

További nehézséget okozhatnak a titkosított kommunikációs csatornák, a nem ismert célállomások, a nem támogatott alkalmazások és a jogosultságokkal visszaélő automatizációk.

A Microsoft dokumentációja is külön kezeli a generatív AI-alkalmazások felderítését és a különböző adatvédelmi kontrollokat. Ez is arra utal, hogy az AI-biztonság nem oldható meg egyetlen DLP-szabály bevezetésével.

A megfelelő védelemhez több kontrollréteg összehangolt működésére van szükség.

9. Hogyan mérhető a vállalat valódi felkészültsége?

A vállalat AI-adatbiztonsági érettségét nem önmagában a DLP megléte vagy az AI-használati szabályzat tartalma határozza meg.

Sokkal beszédesebb, hogy a szervezet képes-e konkrét helyzetekre válaszolni.

  • Felismerhető-e, ha valaki bizalmas dokumentumot tölt fel egy nem engedélyezett AI-szolgáltatásba?
  • Megkülönböztethető-e a szolgáltatás használata az érzékeny adat tényleges továbbításától?
  • Ellenőrizhető-e a vállalati alkalmazásokból induló külső AI API-forgalom?
  • Azonosíthatók-e az AI által használt belső adatforrások és hozzáférések?
  • Van-e kontroll az AI-agentek által végrehajtható műveletek felett?
  • Megállapítható-e, hogy egy észlelt adatátadás szabályos üzleti tevékenység vagy biztonsági esemény?

Ezek a kérdések nem feltétlenül egyetlen termék képességeiről szólnak. Sokkal inkább arról, hogy a vállalat technikai és szervezeti kontrolljai együtt képesek-e kezelni az AI-használatból eredő kockázatokat.

Összegzés

A DLP fontos része lehet a Shadow AI elleni védekezésnek, de nem tekinthető az AI-adatbiztonság teljes megoldásának.

A generatív AI elterjedésével nemcsak az adatvesztés lehetséges útvonalai változnak meg, hanem az is, hogy milyen rendszerek kezdeményezhetnek adatátadást. Egy felhasználói másolás, egy dokumentumfeltöltés, egy API-hívás és egy AI-agent által végrehajtott művelet különböző technikai kontrollokat igényelhet.

Ezért a vállalatnak nem elegendő azt tudnia, hogy milyen AI-szolgáltatásokat használnak a munkatársai. Az adatáramlásokat is értenie kell, beleértve az adat forrását, a célállomást, az alkalmazás szerepét és az adat érzékenységét.

A legfontosabb kérdés tehát nem az, hogy van-e DLP a vállalatnál, hanem az, hogy a DLP és a többi biztonsági kontroll együtt lefedi-e azokat az adatfolyamokat, amelyek valóban kockázatot jelentenek.

Mert a kontroll megléte még nem bizonyítja a megfelelő lefedettséget. A biztonsághoz azt is ismerni kell, hogy hol vannak a vakfoltok. :::

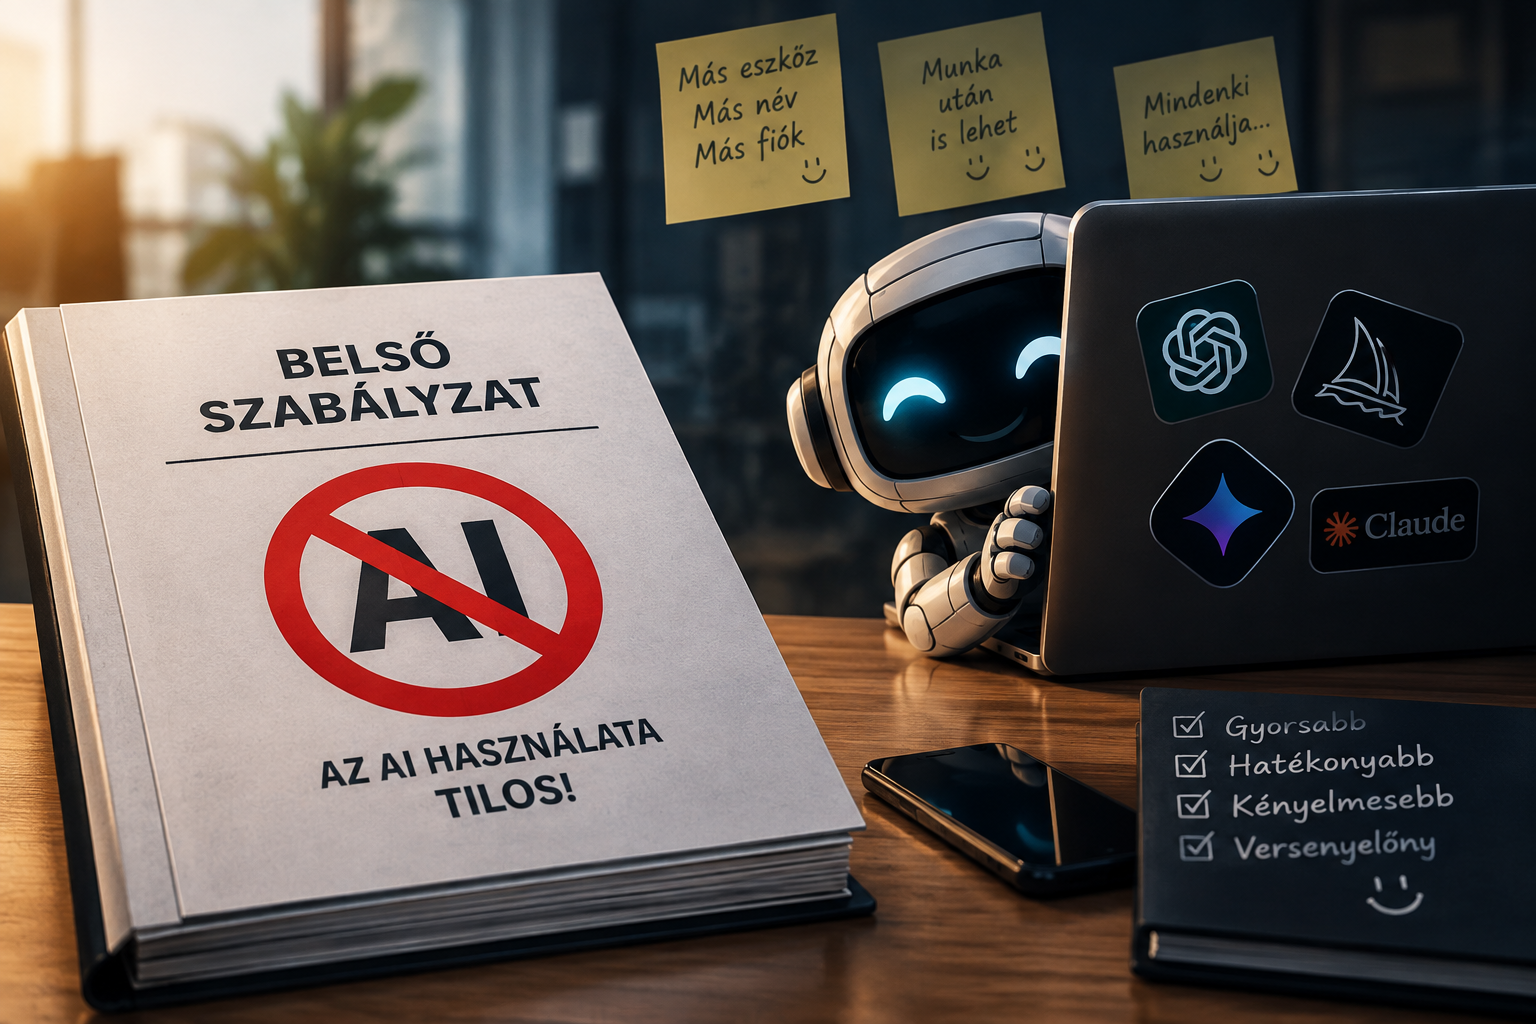
Miért nem elég az AI használatát szabályzatban tiltani?

A generatív mesterséges intelligencia vállalati elterjedése új kihívás elé állítja az információbiztonsági szervezeteket. A munkatársak számára ma már természetes lehet, hogy egy AI-szolgáltatást vesznek igénybe szövegíráshoz, elemzéshez, fordításhoz, programozáshoz vagy dokumentumok feldolgozásához.

A vállalat erre többféleképpen reagálhat. Az egyik legegyszerűbb megoldás egy olyan belső szabályzat létrehozása, amely meghatározza, hogy milyen AI-szolgáltatásokat szabad használni, milyen adatokat lehet azokba feltölteni, vagy akár teljesen megtiltja a nyilvános AI-szolgáltatások használatát.

Egy ilyen szabályzat önmagában azonban nem jelent megfelelő információbiztonsági kontrollt.

Ennek oka nem az, hogy a szabályzat szükségtelen lenne. Éppen ellenkezőleg: egyértelmű elvárások nélkül nehéz meghatározni, hogy a munkatársak milyen keretek között használhatják az AI-t. A probléma az, hogy a szabályzat megmondja, mit szabad vagy mit nem szabad megtenni, de önmagában nem akadályozza meg a szabály megszegését, és nem feltétlenül teszi láthatóvá annak megtörténtét.

Ez az AI esetében különösen fontos, mert a szolgáltatások használata gyakran nem igényel semmilyen vállalati infrastruktúra-módosítást.

A Shadow AI kialakulása

Az előző cikkben szó esett a Shadow IT AI vonatkozásairól. A klasszikus Shadow IT esetében a vállalat olyan technológia használatával szembesül, amelyet az IT-szervezet nem hagyott jóvá vagy nem tart nyilván.

A generatív AI ezt a problémát tovább nehezíti.

Egy munkatársnak nem kell alkalmazást telepítenie. Nem kell új szervert létrehoznia, és sok esetben nem kell vállalati rendszergazdai jogosultsággal rendelkeznie sem. Egy böngészőből elérhető egy AI-szolgáltatás, amelyhez akár néhány perc alatt hozzáférhet.

A kockázat ezért nem feltétlenül az, hogy a vállalatnál ismeretlen szoftver fut.

Lehet, hogy egyáltalán nem fut új szoftver a vállalati infrastruktúrán.

A munkatárs egyszerűen adatot küld egy külső szolgáltatásnak.

Ez történhet például akkor, amikor egy alkalmazott egy szerződést szeretne összefoglalni, egy hibás forráskódot akar kijavíttatni, egy ügyfélpanaszra szeretne választ készíteni, vagy egy belső dokumentum alapján szeretne prezentációt létrehozni.

A szándék önmagában nem rosszindulatú. A munkatárs munkát szeretne végezni hatékonyabban.

Információbiztonsági szempontból azonban a kérdés az, hogy milyen adat hagyta el a vállalati kontrollált környezetet, és milyen szolgáltatáshoz került.

Az OWASP 2025-ös LLM-kockázati listája külön kockázatként kezeli a Sensitive Information Disclosure problémáját, amely magában foglalhat személyes adatokat, pénzügyi információkat, bizalmas üzleti adatokat, hitelesítési adatokat és jogi dokumentumokat is. (OWASP Gen AI Security Project)

A tiltás és a technikai kontroll különbsége

Egy AI-használati szabályzat például kimondhatja:

„Bizalmas vállalati adat nyilvános AI-szolgáltatásba nem tölthető fel.”

Ez egy teljesen ésszerű követelmény.

A kérdés azonban az, hogy mi történik akkor, ha valaki mégis feltölt egy ilyen dokumentumot.

Három különböző helyzet képzelhető el.

Az első esetben a vállalat rendelkezik szabályzattal, de nincs technikai kontroll. A munkatárs feltölti az adatot, az esemény pedig valószínűleg csak akkor válik ismertté, ha valaki később észreveszi valahogyan(?).

A második esetben van technikai kontroll is. Például a vállalat képes felismerni bizonyos AI-szolgáltatások használatát, naplózza a forgalmat, vagy DLP-rendszeren keresztül vizsgálja az adatmozgást.

A harmadik esetben a kontroll nemcsak észlel, hanem szükség esetén meg is akadályozza az adatátadást.

A három modell között jelentős különbség van.

A szabályzat az első szinten is létezik, de önmagában egyik esetben sem garantálja, hogy a szabályt betartják.

A felhasználói “hiba” nem szüntethető meg szabályzattal

Az információbiztonságban régóta ismert probléma, hogy a biztonsági kontrollok nem építhetnek kizárólag arra, hogy minden felhasználó mindig helyesen fog viselkedni.

Az AI esetében ez különösen jól látható.

Egy munkatárs nem feltétlenül tudja eldönteni, hogy egy adott dokumentum milyen adatvédelmi vagy információbiztonsági kategóriába tartozik.

Lehet, hogy tudja, hogy az ügyfél neve érzékeny adat.

De mi a helyzet egy belső üzleti tervvel?

Egy hibajeggyel?

Egy konfigurációs fájllal?

Egy forráskóddal?

Egy olyan dokumentummal, amelyben nincs jelszó, de szerepel benne egy belső rendszer felépítése?

A szabályzat egyértelműbbé teheti ezeket a kérdéseket, de nem képes minden helyzetet előre meghatározni.

Ezért a szabályzatnak nem a technikai kontroll helyettesítőjeként, hanem annak részeként kell működnie.

Az AI használata ráadásul nem feltétlenül látható az IT számára

A hagyományos Shadow IT egyik problémája az, hogy az IT-szervezet nem tudja, milyen alkalmazások vannak használatban.

AI esetében ehhez hozzáadódik az úgynevezett SaaS-jellegű használat.

A felhasználó ugyanazon a vállalati laptopon dolgozik tovább, ugyanazzal az operációs rendszerrel, ugyanazzal a böngészővel.

A különbség mindössze annyi, hogy egy weboldalon megnyitott egy AI-szolgáltatást.

Ha a vállalat nem rendelkezik megfelelő láthatósággal, akkor nehéz megválaszolni az alapvető kérdéseket:

  • Mely AI-szolgáltatásokat használják?
  • Melyik szervezeti egység használja őket?
  • Milyen célból?
  • Milyen adatokat továbbítanak?
  • Használnak-e személyes fiókokat?
  • Milyen külső API-khoz kapcsolódnak?
  • Történik-e automatizált adatátadás?

A NIST generatív AI-ra vonatkozó kockázatkezelési profilja ezért az AI használatával kapcsolatban a szervezeti governance, a dokumentáció, a nyomon követés és az emberi felülvizsgálat szükségességét is hangsúlyozza. (NIST)

A probléma második szintje: amikor az AI nemcsak feldolgoz, hanem fejleszt

A szabályozási probléma még összetettebbé válik, amikor az AI-t nem egyszerűen munkát támogató eszközként használják, hanem szoftverfejlesztésre.

Egy munkatárs AI segítségével létrehozhat egy olyan scriptet vagy kisebb alkalmazást, amely vállalati adatbázishoz, API-hoz vagy fájlrendszerhez kapcsolódik.

Ilyenkor már nem pusztán arról van szó, hogy a munkatárs egy külső AI-szolgáltatásba adatot küldött.

Létrejött egy új szoftverkomponens is.

Ennek pedig lehet:

  • adatbázis-hozzáférése,
  • API-kulcsa,
  • felhasználói jogosultsága,
  • külső kommunikációja,
  • naplózása,
  • függősége,
  • sérülékenysége,
  • és üzleti funkciója.

Ha erre csak egy általános AI-használati szabályzat vonatkozik, az nem feltétlenül elegendő.

A vállalati alkalmazásbiztonsági folyamatoknak azt is kezelniük kell, hogy ki hozhat létre alkalmazást, milyen környezetben, milyen adatokhoz férhet hozzá, hogyan kerülhet üzembe, és milyen biztonsági ellenőrzéseken kell átmennie.

Az AI által generált kód sem tekinthető megbízható kódnak

Az AI által előállított kód esetében ugyanazok a biztonsági alapelvek érvényesek, mint bármely más fejlesztésnél.

A generált kódot ellenőrizni kell.

Ez nem feltétlenül azért szükséges, mert az AI „rosszindulatú” vagy szándékosan hibás kódot készít. Sokkal egyszerűbb oka van: az AI nem ismeri automatikusan a vállalat teljes architektúráját, jogosultsági modelljét, adatvédelmi követelményeit és biztonsági szabályait.

Az OWASP külön kockázatként kezeli az LLM-ek kimenetének nem megfelelő kezelését. Ha egy AI által generált kimenet megfelelő validáció nélkül kerül tovább egy másik rendszerhez, az például injection-hoz, jogosultság-emeléshez vagy akár távoli kódfuttatáshoz is vezethet. (OWASP Gen AI Security Project)

Ez különösen fontos akkor, ha a fejlesztő az AI által generált kódot vagy SQL-lekérdezést ellenőrzés nélkül használja.

Az agentek újabb problémát jelentenek

A következő lépcső az AI-agentek megjelenése.

Egy hagyományos chatbot elsősorban választ ad.

Egy agent azonban már képes lehet más rendszereket elérni és műveleteket végrehajtani.

Ilyen lehet például egy adatbázis lekérdezése, fájl létrehozása, e-mail küldése vagy egy vállalati rendszerben végrehajtott módosítás.

Itt már nem elegendő azt vizsgálni, hogy „használhatja-e a munkatárs az AI-t”.

Azt is vizsgálni kell, hogy milyen jogosultságot kapott az AI által használt rendszer, és milyen műveleteket hajthat végre.

Az OWASP ezt Excessive Agency néven külön kockázati kategóriaként kezeli. A probléma egyik alapvető oka lehet a túl széles funkcionalitás, a túlzott jogosultság vagy a túl nagy autonómia. (OWASP Gen AI Security Project)

Ez már klasszikus információbiztonsági kérdés: a rendszer csak ahhoz férjen hozzá, amire ténylegesen szüksége van. Sokszor azonban az agentek a felhasználó saját felhasználói adataival és jogosultságaival futnak, aminél garantált, hogy a szükségesnél nagyobb jogosultsággal bír az agent, mint amire az adott folyamatban szükség vam.

Mit jelent akkor a megfelelő AI-governance?

A megoldás nem az, hogy nincs szükség szabályzatra.

Éppen ellenkezőleg.

Szükség van szabályzatra, de a szabályzatnak egy kontrollrendszer részeként kell működnie.

Egy érett megközelítés legalább négy réteget különít el.

1. Szabályozás

Meg kell határozni:

  • milyen AI használható,
  • milyen célra,
  • milyen adatokkal,
  • milyen fiókkal,
  • milyen feltételekkel.

2. Láthatóság

A vállalatnak képesnek kell lennie az AI-használat feltérképezésére.

Ide tartozhat:

  • hálózati forgalom elemzése,
  • SaaS-felderítés,
  • endpoint telemetry,
  • identitáskezelés,
  • API-használat,
  • naplózás.

3. Megelőzés

Ahol indokolt, technikai kontrolloknak kell megakadályozniuk a nem engedélyezett adatátadást vagy hozzáférést.

Itt jöhet szóba például DLP, webes hozzáférés-szabályozás, identity-based access control vagy megfelelő API-kontroll.

4. Biztonságos fejlesztés

Az AI-val létrehozott alkalmazást nem azért kell külön kezelni, mert AI készítette.

Azért kell kezelni, mert vállalati alkalmazás lett belőle.

Ha vállalati adatot kezel, akkor ugyanúgy szükség lehet:

  • forráskód-kezelésre,
  • code review-ra,
  • dependency-ellenőrzésre,
  • secret managementre,
  • jogosultságvizsgálatra,
  • naplózásra,
  • biztonsági tesztelésre.

A szabályzat tehát szükséges, de nem elégséges

Az AI-használati szabályzat fontos alap.

Segít meghatározni a vállalat elvárásait, kijelölni a felelősségeket, és egyértelművé tenni, hogy bizonyos adatok milyen környezetbe nem kerülhetnek.

De egy olyan szabályzat, amely mögött nincs technikai kontroll, nagyjából ugyanazt a problémát kezeli, mint amikor egy vállalat azt mondja:

„A munkatársaknak tilos jelszavakat megosztaniuk.”

Ez helyes szabály.

De ettől még nem lesz megfelelő a vállalat jelszóbiztonsága.

Ugyanígy:

„Bizalmas adatot tilos nyilvános AI-szolgáltatásba feltölteni.”

Ez is helyes szabály.

A valódi biztonsági kérdés azonban az, hogy a vállalat:

észreveszi-e, ha megtörténik, és képes-e megakadályozni, ha szükséges.

A generatív AI esetében ezért nem önmagában az AI-használat tiltása vagy engedélyezése jelenti a megfelelő biztonsági megközelítést.

A cél inkább egy olyan környezet kialakítása, amelyben az AI használata látható, szabályozott és technikailag kontrollált.

Ez különösen fontos azért, mert az AI használatának kockázata nem áll meg az adatbevitel oldalán.

Az AI ma már képes kódot generálni, rendszerekkel kommunikálni és bizonyos esetekben műveleteket végrehajtani.

A vállalatnak ezért nemcsak azt kell tudnia, hogy ki használ AI-t.

Azt is tudnia kell, hogy:

milyen adatot ad neki, milyen rendszert épít vele, milyen jogosultságot ad neki, és milyen rendszerekhez engedi hozzáférni.

A szabályzat ennek az alapja.

De önmagában nem kontroll.